Les programmes de vaccination ont plus de vaccins à administrer que jamais. Le pipeline vaccinal ne cesse de s’élargir, mais les ressources dont disposent les programmes élargis de vaccination (PEV) ne progressent pas au même rythme, et les contextes épidémiologiques évoluent rapidement. À mesure que les pays s’approprient davantage leurs ressources de vaccination, ils font face à davantage de choix d’optimisation. Chacun de ces choix repose sur des données que la plupart des PEV et des groupes techniques consultatifs nationaux sur la vaccination (NITAG) ne peuvent pas encore réunir en un seul endroit. Un entrepôt national de données de vaccination (ENDV) est la brique manquante.
L’appropriation par les pays signifie que davantage de décisions sont prises dans le pays, avec des budgets plus serrés. La planification de la vaccination est désormais façonnée par 3 types d’arbitrages. Chacun nécessite une combinaison différente de données.
Chaque vaccin implique un calcul coût-bénéfice. D’un côté se trouve son impact épidémiologique : charge de morbidité évitée et flambées épidémiques prévenues. De l’autre côté se trouvent les coûts opérationnels de prestation. Mettre les deux en balance soulève une question pratique : à partir de quel moment une modalité de prestation devient-elle l’option la plus coût-efficace pour un vaccin et une population donnés ?
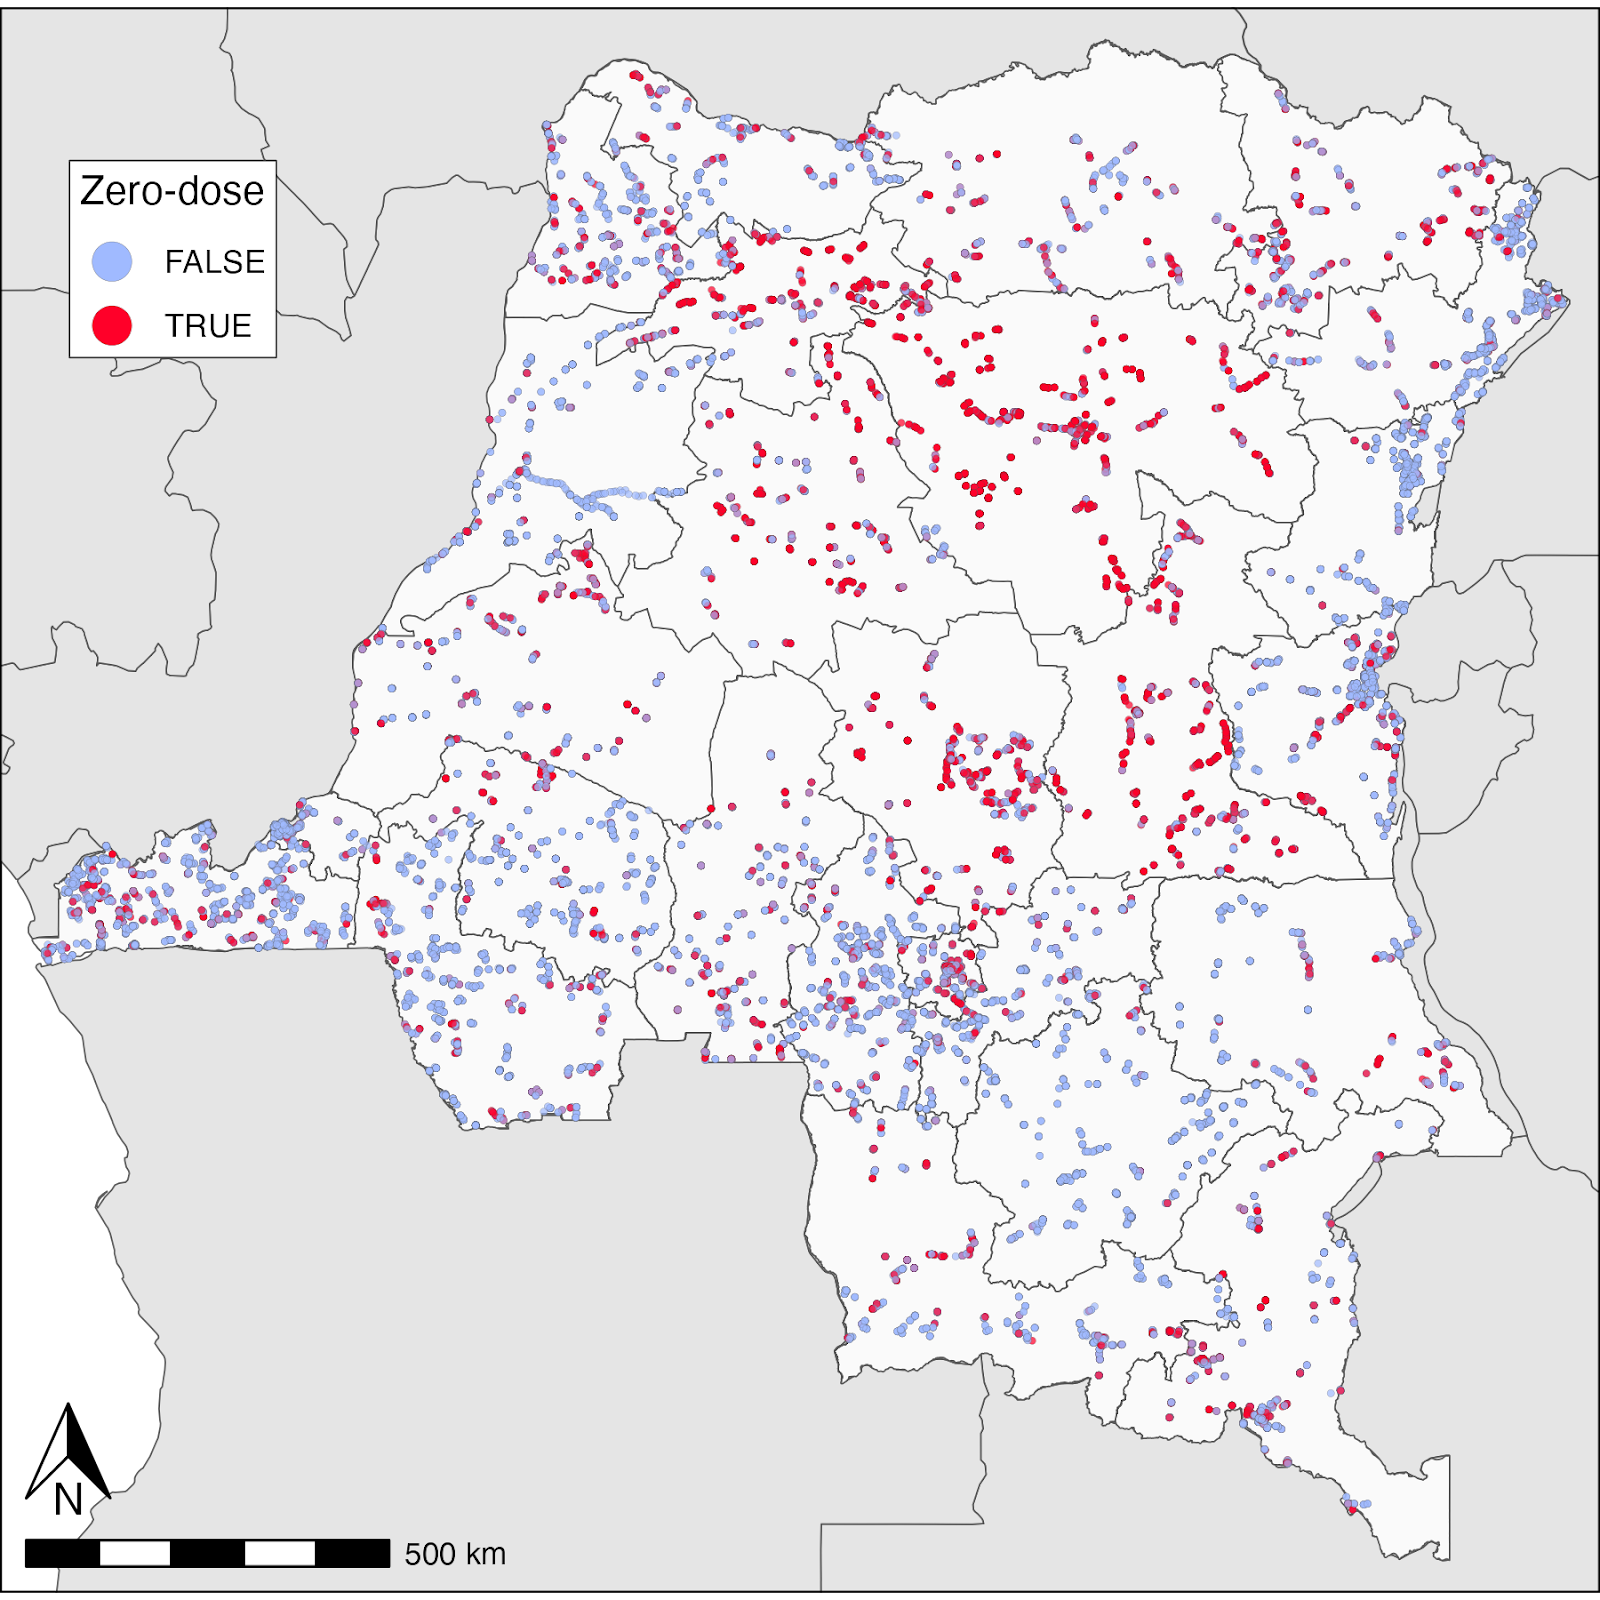
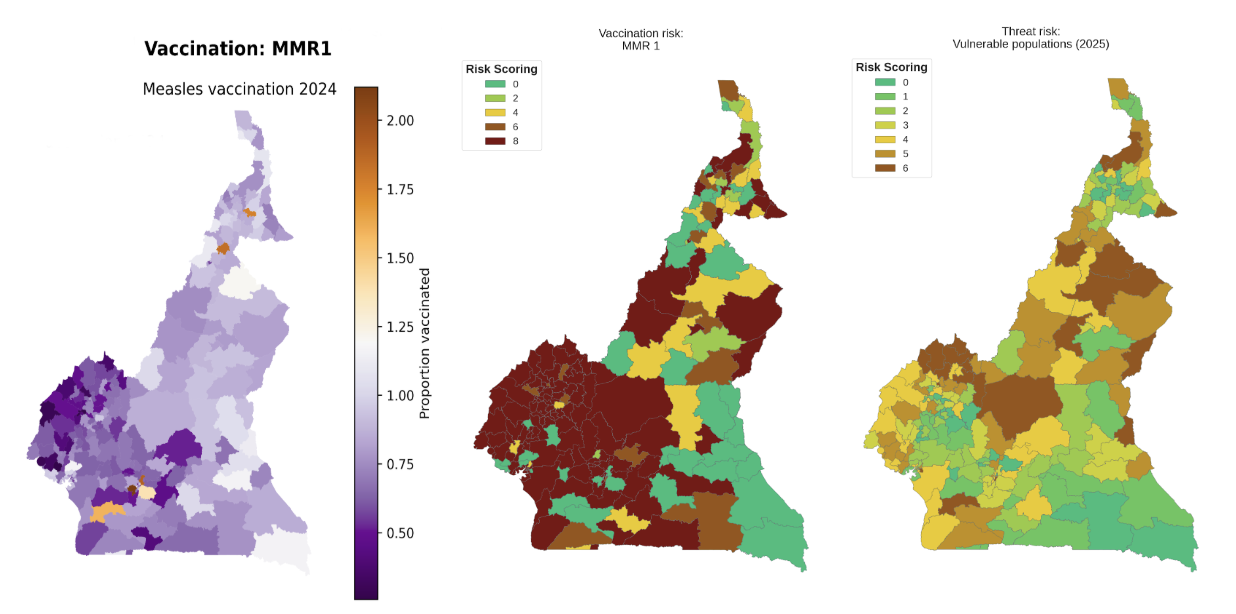
Les programmes doivent aussi arbitrer entre la vaccination de routine, l’intensification périodique de la vaccination de routine (PIRI), et les campagnes de vaccination, et décider où orienter les activités intensifiées et les campagnes. Le ciblage des campagnes dépend de la connaissance des zones où se situent les lacunes d’immunité, de celles où des flambées sont probables, et du coût de mise en œuvre de chaque opération.
Au niveau du district, les responsables du PEV choisissent entre séances en poste fixe, stratégies mobiles et avancées, interventions axées sur la demande, et recherche des contacts. Trouver le bon dosage pour chaque zone exige des preuves sur la couverture, l’accès et l’utilisation des services de vaccination à une échelle géographique fine.
Gavi et ses partenaires formalisent ces choix. Dans le cadre de Gavi 6.0, l’approche d’optimisation et de priorisation du portefeuille de vaccins (VPOP) aide les pays à décider quels vaccins introduire et comment optimiser ceux déjà inscrits à leur calendrier. Parallèlement à VPOP, CashPop applique la même logique d’optimisation au soutien financier programmatique de Gavi, afin que les enveloppes vaccinales et le financement des systèmes de santé soient planifiés ensemble. L’OMS, l’UNICEF et Development Catalysts ont publié une version intermédiaire de la boîte à outils d’optimisation VPOP en mars 2026, et les PEV ont commencé à mener des exercices VPOP avec leurs NITAG, comme en Sierra Leone en septembre 2026, en Somalie, au Sénégal…
La documentation VPOP identifie les données comme une contrainte majeure. L’OMS note que les pays « manquent souvent de données, de capacité et de structures d’appui » nécessaires pour examiner les preuves. Les termes de référence VPOP de Gavi appellent à « veiller à ce que les données existantes soient collectées de manière systématique et centralisées pour éclairer les travaux VPOP ». Un entrepôt national de données de vaccination offre aux pays ce socle centralisé au niveau national.
Les programmes de lutte contre le paludisme se posent des questions similaires depuis des années, et leur expérience offre un point de départ utile.
Les programmes de lutte contre le paludisme font face à des défis comparables, quoique moins complexes. Avec le temps, ils ont développé une vision claire : l’optimisation est au cœur de l’agenda d’élimination et d’éradication du paludisme, et elle dépend d’une infrastructure d’intégration de données. Cette infrastructure doit être un environnement où toutes les données sur le paludisme sont stockées et peuvent servir à la planification, à l’optimisation et à l’évaluation.
L’Organisation mondiale de la Santé (OMS) décrit l’entrepôt national de données sur le paludisme (NMDR) comme une plateforme numérique détenue par le pays, qui réunit des données sur le paludisme provenant de sources multiples dans un système structuré unique. Selon les orientations de l’OMS pour la mise en place d’un entrepôt national de données sur le paludisme, un NMDR rassemble des flux de données qui résident habituellement dans des systèmes distincts :
Un NMDR connecte et harmonise les données de plateformes telles que DHIS2 et les systèmes d’information de gestion logistique (LMIS) sans les remplacer. Le NMDR devient le socle de données de la santé publique de précision du programme de lutte contre le paludisme.
Les programmes nationaux de lutte contre le paludisme mettent actuellement en place des NMDR dans plusieurs pays, dont le Cameroun, la Guinée et le Niger, avec l’appui technique de Bluesquare. La plupart de ces entrepôts fonctionnent sur des instances DHIS2 dédiées, avec OpenHEXA qui assure l’intégration des données et le traitement avancé. Des orientations techniques et opérationnelles standardisées sont en cours d’élaboration avec PATH, CHAI, l’OMS et le Fonds mondial. Une communauté de pratique francophone relie aussi les pays concernés (enseignements de mise en œuvre sur la DHIS2 Community).
Les programmes de vaccination pourraient s’appuyer sur le même modèle, mais leur paysage de données est plus complexe.
La fragmentation des données est un défi plus important pour la vaccination que pour le paludisme. Pourtant, il existe moins d’orientations sur la manière de la traiter.
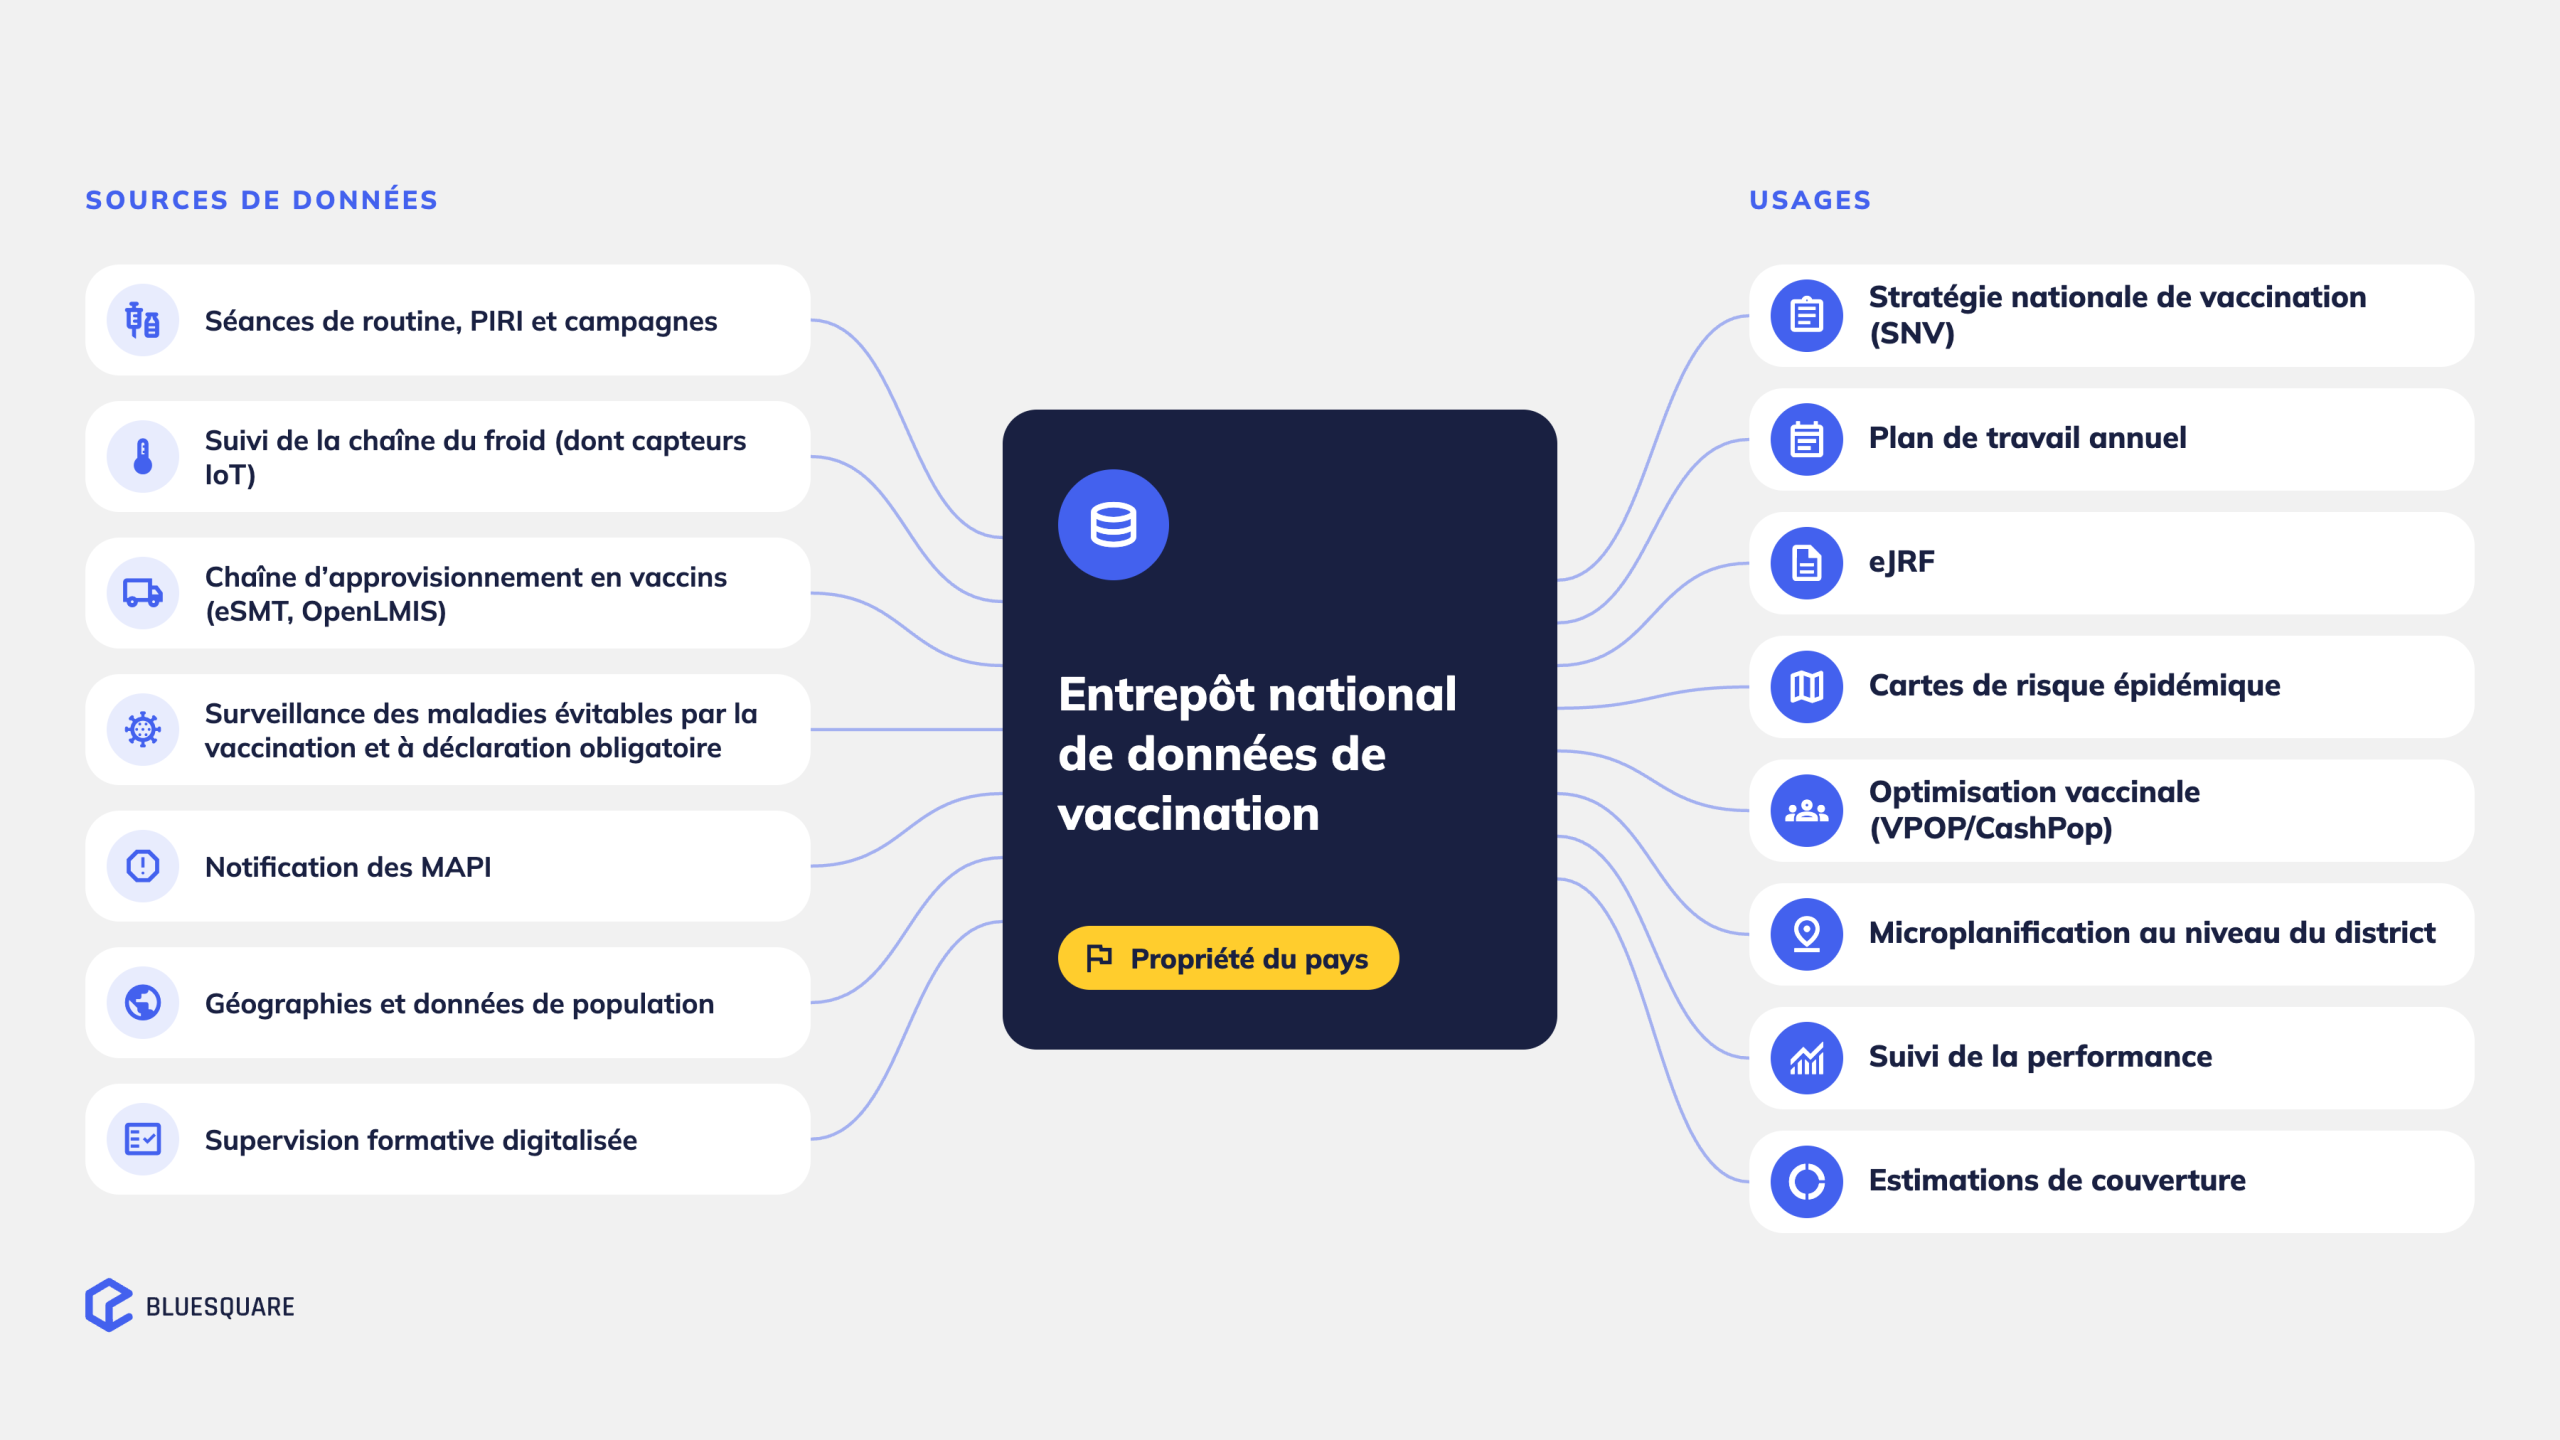
Un PEV type génère des données à travers de nombreux systèmes distincts :
Chaque flux répond à une partie de la question. Aucun d’entre eux ne répond seul à la question dans son ensemble.
Malgré cette fragmentation, peu de références existent sur l’intégration des données de vaccination. Les responsables des PEV et leurs partenaires n’ont toujours pas de réponse à 3 questions de base : par où commencer, quelle infrastructure utiliser et quels produits de données construire en premier.
Répondre à ces questions ouvre un large éventail d’usages.
Un entrepôt national de données de vaccination réunit les flux de données du PEV dans un environnement unique et gouverné que le pays détient et contrôle pleinement. Les PEV peuvent utiliser ces données intégrées pour planifier et suivre la prestation, et les NITAG peuvent s’appuyer sur la même base de preuves pour leurs recommandations. Parmi les usages :
Quel que soit le cas d’usage, la même base intégrée est nécessaire. Un ENDV constitue cette base.
L’expérience des NMDR montre ce qui devient possible lorsqu’un programme possède un environnement de données intégré. Les programmes de vaccination méritent la même base, adaptée à leurs propres flux de données et décisions. Bluesquare veut contribuer à façonner le concept d‘entrepôt national de données de vaccination aux côtés de l’OMS, des PEV, des NITAG et des partenaires techniques.
Si cette approche vous semble pertinente et que vous souhaitez travailler ensemble sur ce sujet, contactez-nous via notre page d’expertise en vaccination, ou renseignez-vous sur nos travaux sur les données du paludisme.